Airing:一次 LLM 推理从 tokenizer 到 sampling 的 28 个站点
一个站点汇集多种技术内容
Airing 的首页把 Blog、Notes、Channel 和项目等入口并列呈现,并链接到多篇适合分段阅读的技术长文。可见主题包括 Pi Agent 中用户消息的处理过程、Chromium CSS 引擎、TLS 1.3 握手,以及 llama.cpp 的模型推理流程。站点的中英文入口为不同语言的读者提供切换方式;长篇文章则通过目录把主题拆成多个章节,适合按概念逐段阅读,也适合遇到具体术语时直接定位。
《一次 LLM 推理的一生 —— 一个 prompt 在 llama.cpp 里走过的 28 个站》关注的是一次输入如何经过推理程序并逐步得到输出。文章没有把模型当作一个黑盒,而是以一个 prompt 为线索,沿着 tokenizer、embedding、attention、KV cache、MoE、logits 和 sampling 等环节逐步展开。这样的安排让读者可以把模型术语放回到一条实际计算链路上,而不是孤立记住一串名词。
从文本输入进入模型计算
文章开头围绕 prefill 与 decode、tokenizer 和 embedding 等步骤展开。标题和目录把一次推理划分成不同阶段:文本先被拆成模型能够处理的 token,随后进入嵌入表示与后续网络计算。文中还单独列出 batch 和 ubatch,提示读者除了模型结构本身,输入如何组织与计算也属于推理过程的一部分。跟随这些章节阅读,可以先把注意力放在“当前数据处于哪一步”,再理解每个模块名称所对应的位置。
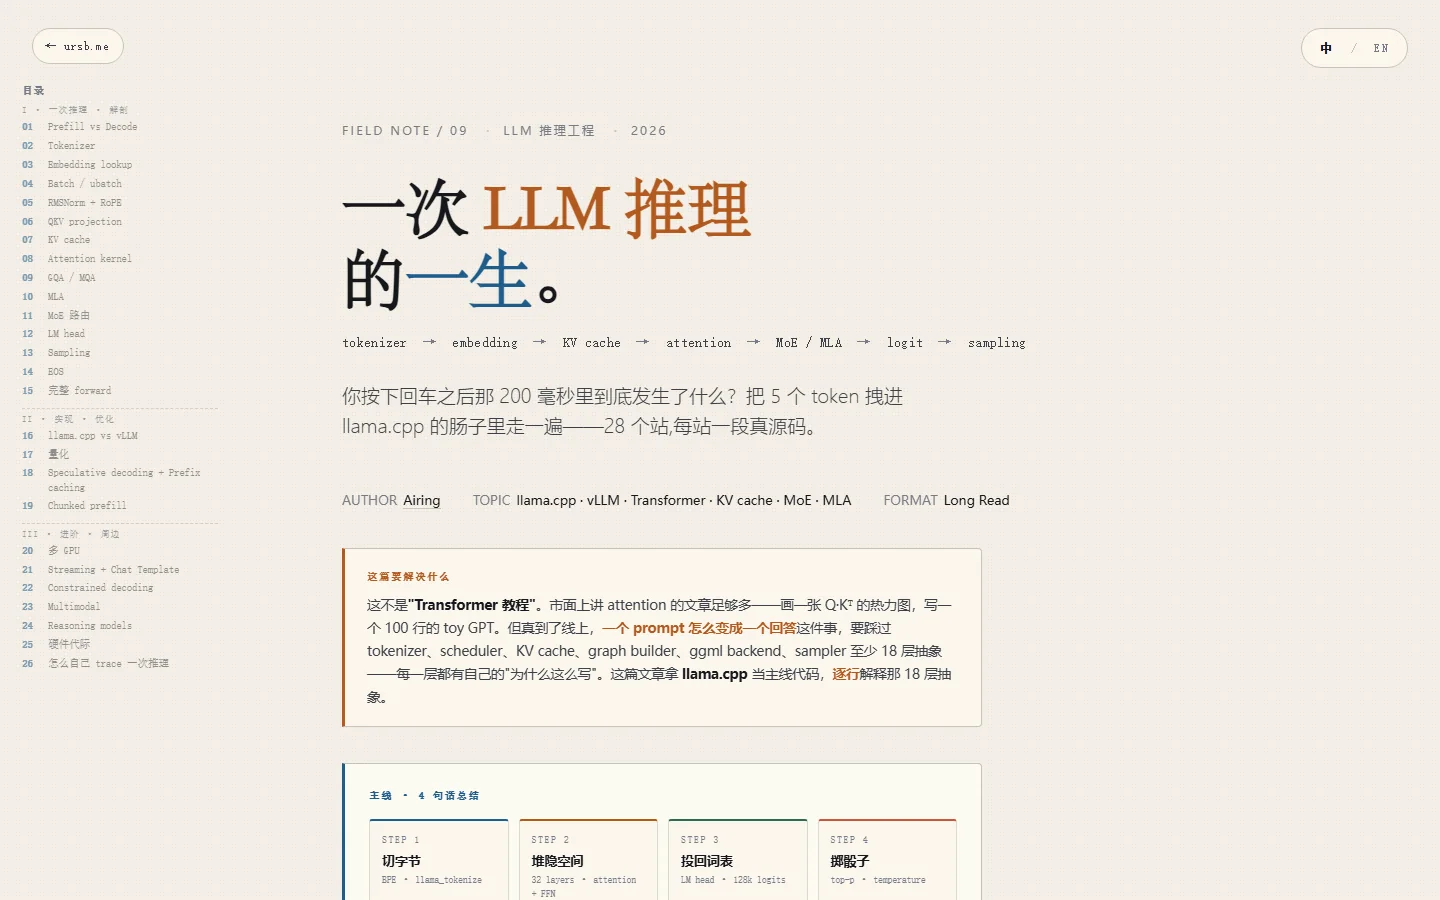
接下来的章节列出 RMSNorm 与 RoPE、QKV projection、KV cache、attention kernel,以及 GQA、MQA、MLA 和 MoE 路由等主题。它们属于模型计算过程中的不同环节,文章通过按顺序组织目录,帮助读者从输入表示逐渐进入注意力和模型层内部,再走向输出侧。对于正在了解本地推理实现的人,这种目录结构能够帮助建立“前后顺序”的概念:缓存、注意力或路由相关概念出现在模型处理流程中的哪个位置。
在后半段,文章把 LM head、sampling、EOS 和完整 forward 纳入同一条推理路径。读者由此可以把“模型内部计算”和“最终生成文本”联系起来,理解为什么一次对话请求包含多个相互衔接的步骤。这里的重点是构成过程的全景视角,具体公式、张量形状或源码实现则应结合文章对应章节和 llama.cpp 源码继续深入。
从理论步骤转向运行时实现
这篇文章还专门安排了实现与优化部分,目录包括 llama.cpp 与 vLLM 对比、量化、speculative decoding、prefix caching 和 chunked prefill 等内容。它们把阅读范围从单次模型计算扩展到推理引擎如何组织执行。对开发者来说,这些主题可以帮助提出更具体的问题:模型参数如何存储、输入是否分段处理、已有前缀能否复用、推理流程中是否会引入额外候选计算。
更进阶的目录则覆盖多 GPU、streaming、chat template、constrained decoding、多模态和 reasoning models 等周边议题。把这些主题放在同一篇长文中,能让读者看见本地模型推理不仅涉及 transformer 内部层,也包括输入格式、运行环境、生成约束和输出交互等实际组件。不同章节可以单独作为索引使用,再按项目实际需要查阅源码或其他说明资料。
怎样使用这份长文
如果你刚接触 llama.cpp 或大模型推理,可以先沿目录理解整体路径,而不必一开始就深入每项优化技术。先看文本如何进入模型、模型内部依次处理哪些阶段、输出如何通过采样形成,再回到自己遇到的问题选择相关章节。已经有推理部署经验的读者,则可以跳到量化、缓存、多 GPU 或 streaming 等专题,把文章当作术语索引和结构化回顾。
目录也适合反向查找。当你在日志、源码或配置中遇到 KV cache、ubatch、prefix caching 等概念时,可以定位到对应章节,查看它在整条推理链路中的上下文。这样能减少只凭术语名字推断功能的情况。站点所展示的内容是技术解释与阅读材料,实际行为仍应以所用推理引擎版本、模型和运行配置为准。
其他文章带来的阅读路径
llama.cpp 长文不是站内唯一的系统性专题。Airing 还列出 Pi Agent 的消息处理过程、Chromium 样式引擎和 TLS 握手等技术文章,它们同样采用沿着一个对象或事件逐步展开的讲解方式。读者可以由此比较不同系统的处理链:一个关注 prompt 如何经过推理实现,一个关注用户消息如何在 Agent 内流转,另一些则围绕浏览器或网络协议中的各个步骤展开。
这种写法适合需要从模块结构理解软件系统的开发者和技术学习者。文章标题提供主题,目录给出路线,正文再按站点逐步展开。对于大型系统来说,先有一张全流程地图,往往比孤立阅读单个组件更容易理解接口之间的关系。读者可以从其中一篇开始,再通过首页的技术文章列表选择相邻领域。
适合谁阅读
如果你正在学习大语言模型推理、阅读 llama.cpp 的实现,或希望了解 prompt 从输入到采样输出大致经过哪些阶段,这篇文章提供了一份结构清楚的长文入口。它也适合希望建立模型运行全景、再挑选量化或缓存等具体主题深入的人。站点的双语入口和分章节目录让读者可以按自己的阅读方式继续探索。
总体来看,Airing 的技术内容把复杂系统拆成可追踪的过程。llama.cpp 这篇长文从 tokenizer 和 embedding 开始,经过 attention、缓存、路由和输出,再连接到运行时优化及进阶议题。读者可以先用目录建立框架,再针对自己的开发任务查阅需要的环节,逐步把模型概念与真实推理实现联系起来。