Yi's Blog:从 HRM 分层推理到 AI 研究分析
从首页选择研究主题
首页文章列表同时包含 AI 论文讲解、图像处理模型、编程谜题和 Transformer 实作内容。可见主题包括神经网络拼图、Hierarchical Reasoning Model、BrushNet 与 BrushEdit、U-Net,以及从头构建图像描述 Transformer。侧栏分类进一步提供 Machine Learning、Transformer、LLM、Vision、Deep Learning、Diffusion Models、Reasoning、Puzzles 和 Optimization 等入口,让读者可以按兴趣查找文章。
这种组织方式适合把“模型是什么”与“如何分析或实现”连接起来。部分文章以架构和训练机制为线索,部分则通过谜题、图像编辑或代码实践引出具体问题。首页文章通常包含简短介绍和继续阅读入口,便于访客先判断内容方向,再决定是否深入长文。Blog 栏目适合浏览文章,Archives 适合回看历史内容,Stream 则提供另一种站内内容入口。
HRM 文章按组件拆解分层推理模型
《HRM Explained: A 27M Parameter Model That Reasons Without Chain-of-Thought》以 Hierarchical Reasoning Model 为主题。文章开头介绍该模型提出的任务场景,包括数独、迷宫和抽象推理,并概述其参数量、训练样本规模以及不依赖语言或思维链提示的主张。作者随后说明将沿着代码与架构逐步解释模型,并同时讨论后续对相关主张提出的批评。
文章目录把内容拆成几个可单独阅读的部分:两层架构、Adaptive Computation Time 外循环、z_H 与 z_L 的工作记忆、按谜题区分的嵌入,以及用于决定停止或继续的 Q-learning 机制。这样的顺序从整体组件逐渐深入训练与停止条件,帮助读者了解模型作者如何组织推理过程。正文还将停止机制的两个部分分开讨论,其中 q_halt 与真实标签监督有关,q_continue 则采用从未来回传信息的 bootstrapping 方式,并进一步提及冷启动和探索问题。
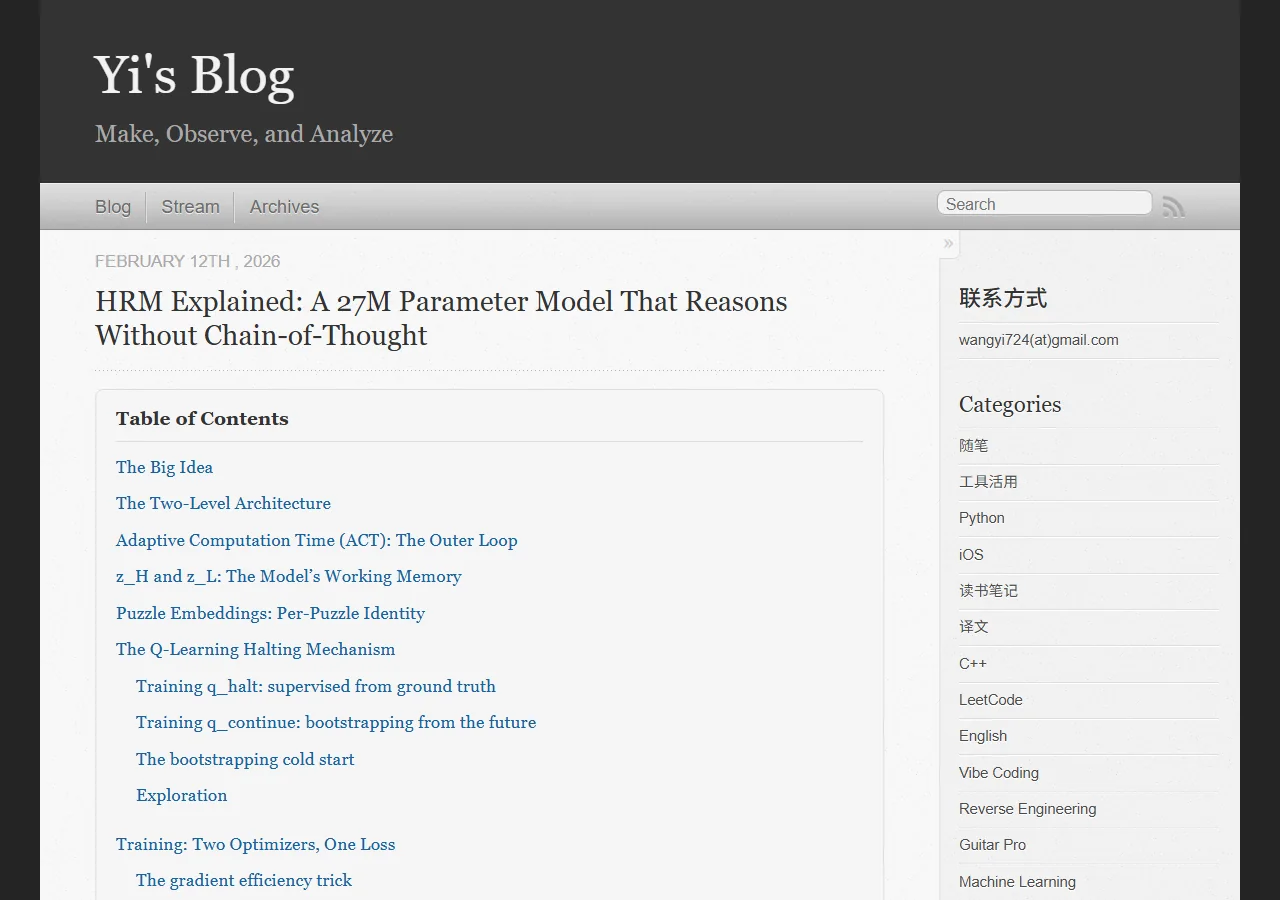
解释模型时也保留限制与争论
HRM 文章没有只列出架构组件。目录还包括两个优化器与一个损失、梯度效率处理、模型无法分支和回溯的限制,以及对研究结论的后续评论。文章列出 ARC Prize 团队的分析和 Ge、Liao、Poggio 的分析作为讨论来源,读者可以沿着这些小节查看不同研究者如何审视同一类能力主张。
对于新模型,介绍性文章有助于先建立结构图景,但模型在特定任务上的表现、数据设置和可迁移性仍需要对照原论文与复现实验。该文的标题和开篇介绍了一个醒目的模型规模与任务描述,读者不宜只根据摘要判断其能力边界;更可靠的阅读方式是把架构讲解、作者实验、外部评估和后续批评分开核对。文章设置独立的批评部分,使这类比较成为阅读路径的一部分,而不是把架构说明等同于最终结论。
读者可以把目录当作一张问题清单来使用:先从 Big Idea 和 Two-Level Architecture 建立整体印象,再查看 Adaptive Computation Time 与工作记忆章节,之后转到停止机制和训练过程,最后阅读限制及外部评论。每个部分对应不同层次的问题,顺序阅读有助于避免只记住模型的宣传描述;按需跳读则适合已经了解架构、只想核对训练或限制的访客。该文章把这些内容分开列出,便于读者围绕自己的问题选择阅读深度。
当文章提及外部分析时,读者可以将其视为进一步比较的入口,而不是直接把目录标题当成论证本身。对照原始论文、训练设置与独立评估,有助于区分架构设计的描述、作者对能力的解释,以及其他团队在评测中提出的疑问。这样阅读也能避免把“无思维链”或“小参数量”这类标签单独当成模型质量的结论。
站点还覆盖视觉模型与实践文章
AI 主题之外,首页还列出 BrushNet 与 BrushEdit 的图像修复和编辑架构讲解、U-Net 入门视觉指南,以及从零构建图像描述 Transformer 的文章。它们分别面向图像编辑、分割网络理解和视觉语言模型实践等相邻主题。神经网络拼图文章则把组合优化问题放进编程谜题背景,介绍作者尝试的不同求解思路。这些文章共同展示了站点的内容范围:不仅介绍模型名称,还尝试说明其结构、使用场景或实现路线。
分类标签可帮助读者从宽泛的 AI 兴趣收窄到具体方向。例如,关注生成视觉的读者可以从 Vision 或 Diffusion Models 入手;对推理与谜题感兴趣的访客,则可浏览 Reasoning、Puzzles 和 Optimization。目录提供导航线索,但具体文章仍有自己的范围与技术前提;阅读时应留意文章日期、引用和所讨论的模型版本。
适合哪些读者
如果你希望了解机器学习架构、视觉模型或推理机制,并偏好从组成部分和代码脉络逐步展开的长文,这个站点可以作为阅读入口。学习者可以先从主题分类找到感兴趣的方向,再利用文章目录定位架构、训练或限制章节;研究人员和工程师则可以把外部分析、原始论文与实现链接作为进一步核实的起点。编程谜题文章也适合想观察模型或算法如何处理特定组合问题的读者。
网站内容属于个人研究与工程写作,适合作为技术概览和文献线索。有关参数规模、训练数据、模型表现和后续评价的判断,应继续查看作者链接的原始研究和独立分析;不同文章的深度和主题也不完全相同。按栏目和目录逐步阅读,能更清楚地区分模型提出的主张、作者的解释以及评论者的质疑。