Jun's Blog:C++、编译器与计算机系统学习记录
文章目录与学习主题
首页展示文章标题和日期,读者可沿时间顺序查看不同阶段的学习记录。操作系统主题以 xv6 为例,便于跟进小型教学系统中的概念;编译器相关文章包括 GraalVM 构建和 LLVM 的中端优化;C++ 主题则讨论 inline 关键字、移动语义、链接与库等基础内容。矩阵乘法和 CUDA 笔记进一步连接到数值计算及并行计算。
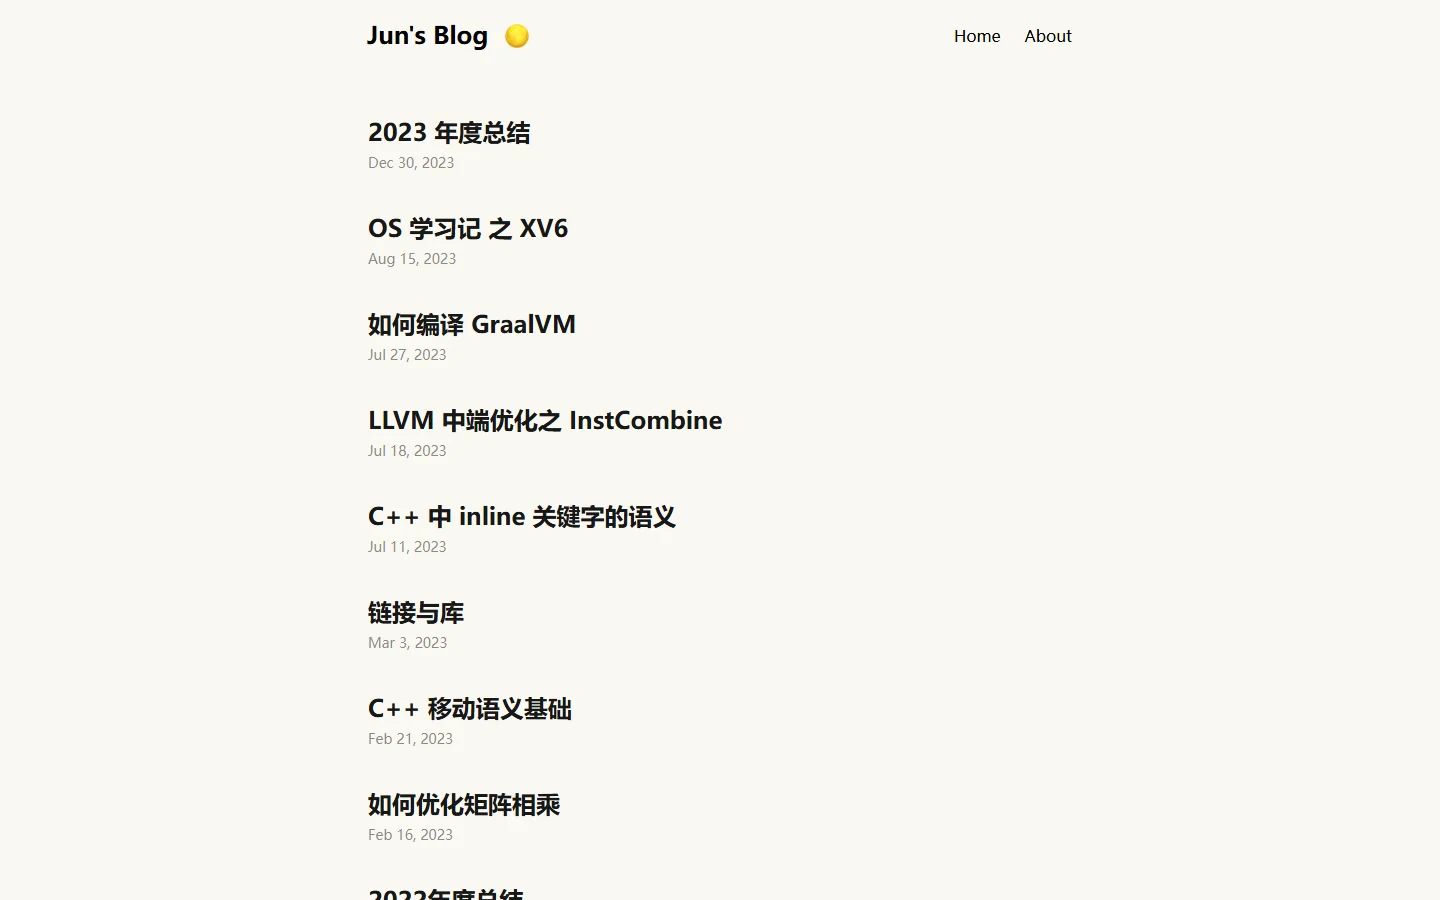
这种从基础语言到系统实现、再到计算性能的内容跨度,为计算机专业学习者提供了多条阅读路径。可以先根据标题选择熟悉的主题,再沿文中引用和相关仓库继续阅读。文章发布于不同时间,涉及编译器、语言标准和 GPU 工具链的内容,需要结合当前版本的官方资料更新理解。
矩阵乘法与性能优化
《如何优化矩阵相乘》从矩阵乘法的定义出发,描述输入矩阵和结果矩阵之间的关系,再比较朴素实现与逐步优化的思路。文章引用 How To Optimize GEMM 作为学习来源,并说明作者对原始示例进行调整后放入自己的公开仓库。读者可以从概念定义开始,观察循环结构如何决定数据访问顺序,进而理解矩阵计算为何会受到内存布局和缓存行为影响。
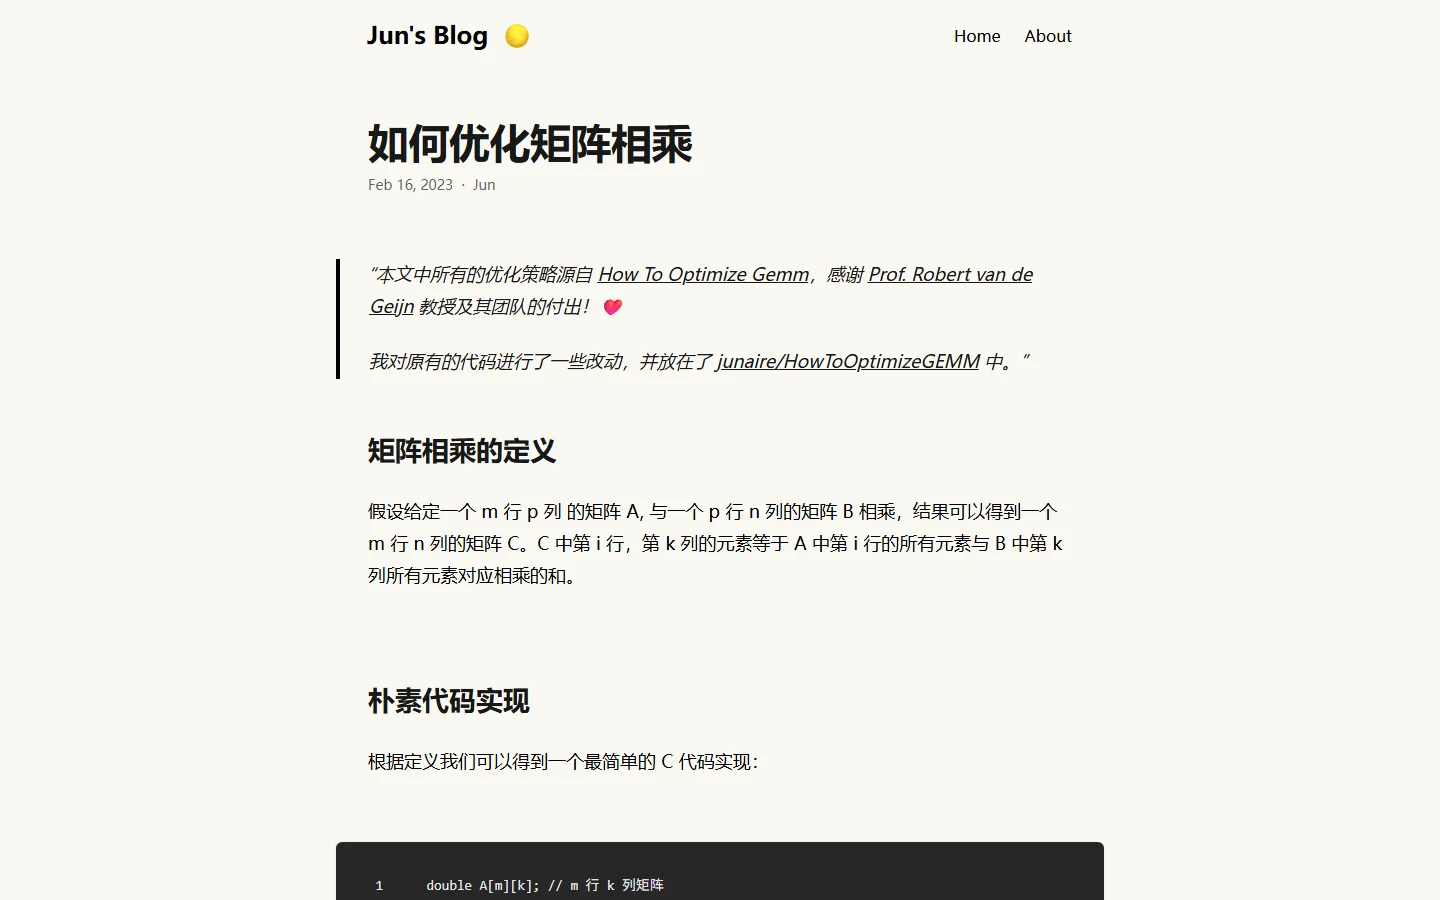
矩阵乘法的计算量较大,简单的三重循环虽然容易理解,但实际性能还受到内存访问效率、数据复用和处理器执行特征影响。优化讨论通常会逐渐引入矩阵分块、调整循环顺序和利用连续内存等概念,让数据在缓存中得到更多复用。文章对原始资料的改动和代码仓库链接为读者提供了进一步实验的入口;不同处理器、编译器和数据规模下的结果可能不同,需要通过基准测试验证。
对照源资料时,可以关注每种实现所改变的因素以及测量条件。性能结果应说明矩阵规模、数据类型、编译选项和硬件环境,否则数值很难直接比较。阅读博客中的实现示例时,可以先用小规模输入验证结果正确,再逐步增加规模观察耗时。这样能将数学定义、程序结构与系统层面的性能表现联系起来。
编译器与语言语义
LLVM InstCombine 文章聚焦编译器中端优化的一类工作。编译器会对中间表示进行分析和变换,尝试用更合适的表达式保持程序语义并改善后续生成结果。学习相关主题时,读者可先理解中间表示和基本优化,再观察具体变换规则的输入、输出及适用条件。GraalVM 构建记录则从另一角度涉及编译工具链本身,展现软件构建需要的依赖和步骤。
C++ inline 与移动语义文章为理解语言机制提供基础入口,链接与库主题则连接编译、链接和程序运行的过程。语言规则和编译器实现之间存在区别:标准规定程序行为边界,编译器可以在不改变可观察行为的前提下优化实现。对具体语法或优化效果的疑问,应结合当前语言标准、编译器文档和可复现的小例子检验。
操作系统与 GPU 计算
xv6 学习记通过教学操作系统讨论进程、内存或系统调用等基础机制。教学系统结构相对精简,适合观察核心概念如何映射到代码;真实操作系统则包含更多硬件支持、兼容性要求和工程复杂度。CUDA 初学笔记将内容延伸到 GPU 编程,读者可以从线程组织、数据传输和并行计算等基本问题进入。实际使用时要核对 CUDA 工具链版本、设备能力和对应开发文档。
这些主题之间相互关联:操作系统管理程序运行和资源,编译器把高级语言转换成可执行形式,链接器组织代码与依赖,GPU 编程则利用并行硬件处理适合的计算任务。博客文章提供个人学习路径,适合建立概念地图;深入实现时还应查看 xv6、LLVM、GraalVM 或 CUDA 项目本身的文档与源码。
适合怎样使用本站
正在学习 C++ 的读者可以从移动语义、inline 和链接主题开始;希望理解编译过程的人可继续查阅 LLVM 与 GraalVM;关注系统软件的人可浏览 xv6;对高性能数值计算感兴趣,则可从矩阵乘法优化和 CUDA 笔记进入。首页时间线和分页适合浏览全部内容,About 页面提供站点介绍。
总体来看,Jun's Blog 将语言基础、编译器、操作系统和计算性能主题组合成一组持续记录。矩阵乘法文章以公开教材和代码仓库为线索,帮助读者把算法定义与内存访问优化联系起来;其他文章则扩展到系统和工具链。它适合作为计算机系统方向的阅读入口,具体实现细节和性能结论需要依照当前工具、硬件与测试条件确认。