白云苍狗的小站:梳理 LLM Agent 的常用设计范式
从归档页浏览技术内容
站点提供 Home、Archives、Links、Projects 与 About 等导航,归档页按年份列出文章。读者既可以查找前端主题开发、VitePress 迁移和自建计数器等实践,也可以从最新的 Agent 文章进入 AI 应用主题。文章以中文解释技术概念,并使用分节标题拆分工作原理、特点和使用场景,便于按需跳读。
LLM Agent 专题的核心阅读价值,是把常见结构放到同一张地图中比较。简单任务可能只需一次模型生成;需要外部信息时则要连接工具;任务更复杂时,还可能增加计划、状态、记忆或多个执行角色。范式越复杂,系统可以处理的流程通常越丰富,但实现、调试和评估的工作也会相应增加。
从单步回答到 ReAct
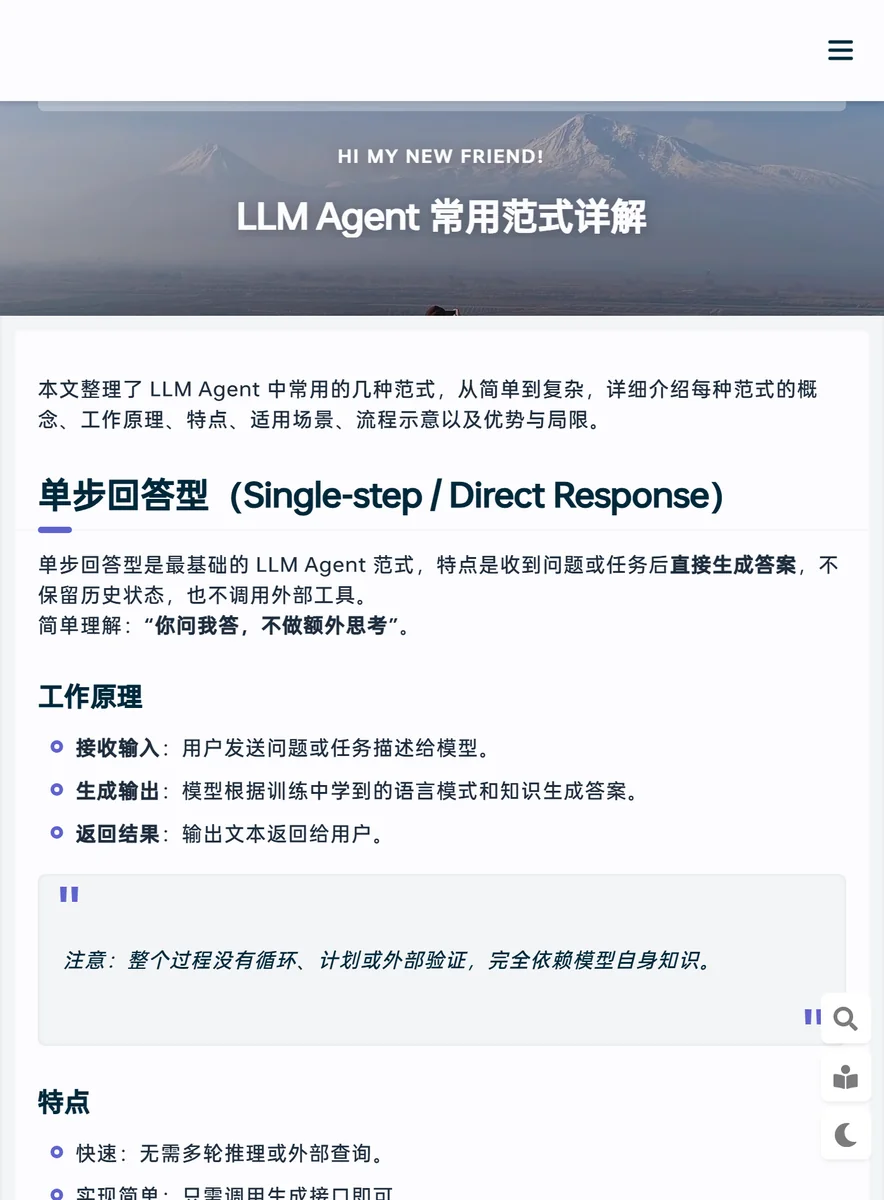
单步回答型是最基础的模式:系统接收用户输入,调用模型生成回复,然后直接返回。它实现简单、响应快,适合翻译、简单解释和无需实时信息的常见问答。因为没有额外工具或验证环节,系统的结果主要取决于模型自身知识;当任务依赖最新数据、外部状态或多步操作时,这种结构就不够用。
链式思维型会在最终答案之前组织中间推导步骤,适合需要拆解的逻辑或多步骤任务。它仍主要依靠模型已有知识,不会自动取得实时资料,也不一定能根据实际执行结果修正计划。工程应用中应关注最终任务是否完成和结果是否可靠,避免把“输出了较长过程”直接当成正确性的保证。
ReAct 将推理与行动结合起来。模型可以提出下一步操作,通过工具查询或执行动作取得反馈,再依据反馈继续处理。这个循环适合需要实时数据、外部 API 或多步任务的场景。它的代价是需要管理工具权限、执行错误、循环停止条件和响应时间;如果工具结果不可信或调用范围过大,Agent 也可能沿着错误方向继续行动。
反思、规划与记忆
反思型流程会先生成初稿,再检查逻辑、格式或约束,并据此修正输出。它可以用于长文本、代码辅助和需要自查的任务,但自我检查仍由模型完成,未必能够发现事实性错误。重要结果仍应通过规则、测试、来源核验或人工审查确认。
Planner + Executor 把复杂任务分成两个阶段:先规划子任务和顺序,再逐项执行并整合结果。这样的结构便于展示进度和定位失败步骤,也适合包含多个依赖环节的任务。设计时要为计划偏差留出重新规划的机会,并让执行器对每一步的输入、结果和失败状态留下清晰记录,否则错误可能在后续步骤中被放大。
记忆增强型 Agent 会从历史对话或外部存储中检索相关信息,再结合当前输入生成结果,并在需要时更新记忆。它适合长期任务和多轮互动,但记忆内容需要区分时效、来源和适用范围。过期信息、相互矛盾的记录或无关上下文,都可能降低回答质量;系统还需要明确保存什么、何时更新,以及如何删除不再需要的数据。
多 Agent 协作与选型
多 Agent 协作会把任务分配给多个角色或执行单元,再汇总各自结果。对于能够自然拆分的研究、审核或内容整理任务,分工可能提高并行度;但协调过程会带来额外通信、状态同步和结果冲突处理。若多个 Agent 重复完成相同工作,或彼此依赖难以并行,复杂架构未必比单一流程更有效。
选择范式时,可以先描述任务本身:是否需要最新信息,是否要调用外部工具,步骤之间是否存在依赖,是否需要长期保存上下文,以及失败时能否安全停止。然后从最简单的结构开始,使用代表性输入验证完成率、响应时间、成本和错误类型。只有当简单流程确实无法满足需求时,再加入工具循环、规划、记忆或多角色协作。
评估与安全边界
Agent 的质量不能只看演示时是否成功,还要观察异常输入、工具失败和信息不完整时的表现。对每种范式,可以建立一组可重复任务,记录结果是否符合要求、是否调用了正确工具、是否在适当时机停止,以及输出是否包含可追溯依据。对有副作用的工具,例如写文件、提交变更或发送请求,应设置明确的权限范围和人工确认点。
范式名称描述的是流程组织方式,不是质量等级。多 Agent 并不必然优于单 Agent,反思也不意味着输出已被独立验证。真实系统通常会组合多种机制,但每增加一层,都应说明它解决了什么问题、引入了什么成本,以及如何发现故障。这个专题把从直接生成到协作执行的常见路线并列展示,便于读者据任务需求选择合适起点,而不是为了复杂而复杂。
除了 Agent 主题,站点还记录 VitePress 主题开发、博客迁移和小型前端项目等实践。读者可以通过分类与归档继续浏览这些内容,了解技术博客中常见的建站和工具实现经验。整体而言,白云苍狗的小站适合希望阅读中文开发笔记、了解 AI Agent 流程结构并寻找前端项目参考的读者。