Roy的个人站:从浏览器自动化文章认识 AI Agent
用 AI 处理网页重复操作
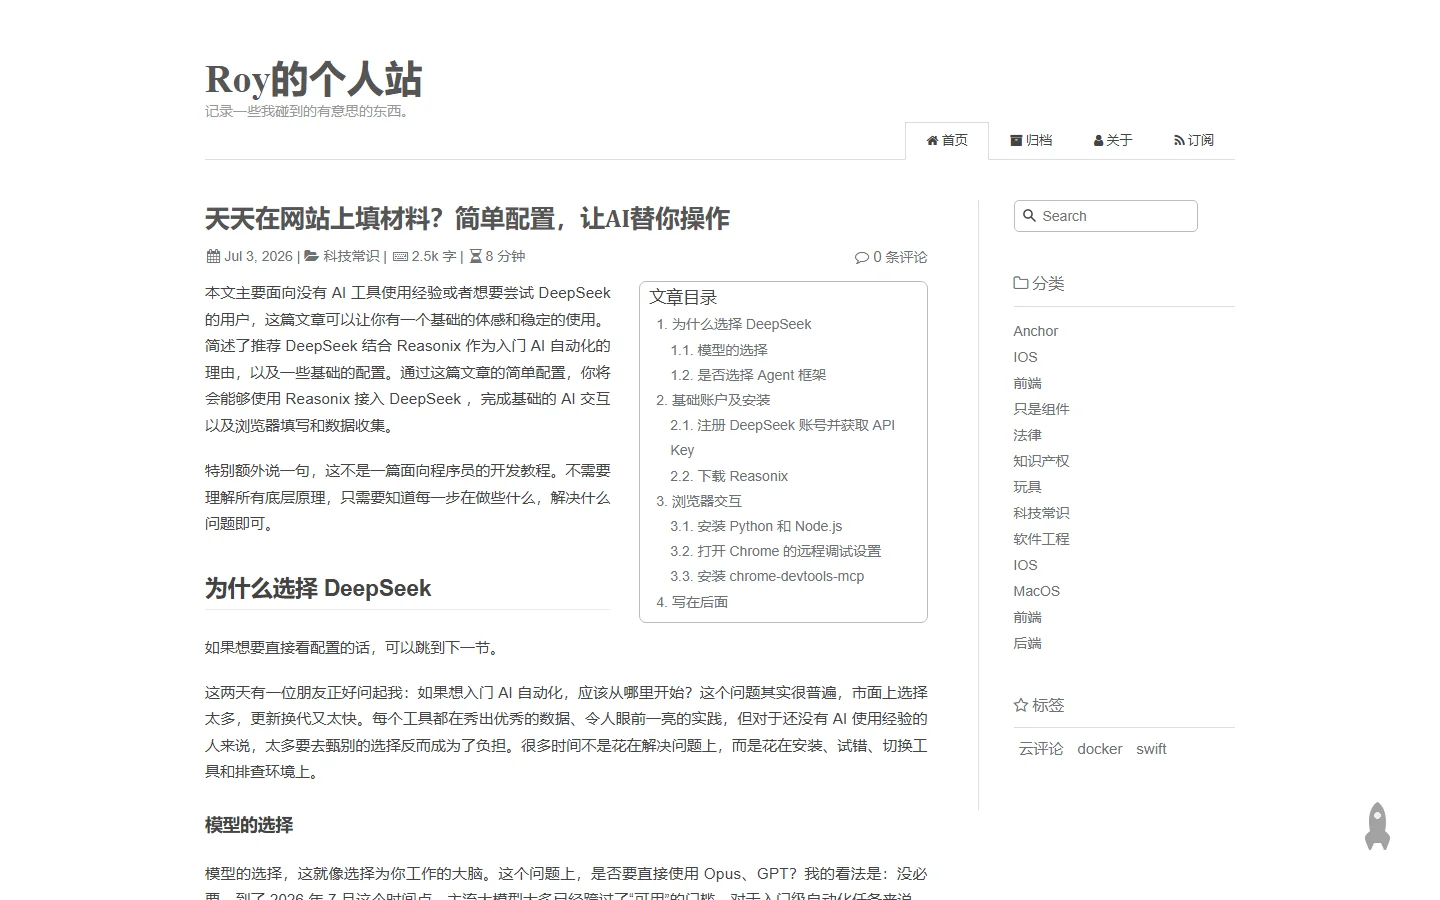
2026 年 7 月发布的《天天在网站上填材料?简单配置,让 AI 替你操作》面向刚开始接触 AI 工具的用户,介绍如何将 DeepSeek 与 Reasonix 配合,用于浏览器交互和资料收集。文章从模型选择和 Agent 框架的作用谈起,再进入账户、安装和浏览器连接部分。它把模型能力与外部工具操作结合起来,展示个人自动化从对话走向网页任务的一个入门尝试。
这类自动化通常由几个部分组成:模型根据提示理解目标并生成计划,Agent 框架负责组织步骤和工具调用,浏览器接口提供页面结构或交互能力,用户则观察结果并决定是否继续。模型本身并不能凭空访问网站;它需要通过浏览器控制、页面读取或其他工具来完成动作。把这些组件区分开,有助于排查任务失败的原因:可能是模型理解错误、工具权限不足、页面结构变化,也可能是浏览器没有处于预期状态。
从对话到可执行任务
纯聊天模型主要生成文本回复,而 Agent 可以把一项复杂请求拆成若干操作,再调用工具执行。例如读取一个公开页面、整理需要的信息、填入表格草稿,或提示用户检查输入是否正确。要实现这条链路,系统需要知道哪些工具可用、每个工具接受什么输入、操作结果如何返回,以及模型何时应该继续、重试或停止。Agent 框架在这里承担的是流程控制和工具编排,不只是给模型换一个界面。
文章将浏览器交互作为入门场景,提到通过 Chrome 远程调试和 chrome-devtools-mcp 连接浏览器。远程调试让外部程序能够观察和操作浏览器实例,MCP 工具则提供标准化的调用接口,使 Agent 能访问页面内容或触发交互。这样的组合能够让用户看到 AI 如何与网页连接,也让技术学习者理解“模型服务”和“执行环境”之间还需要工具协议。
自动化需要清楚的权限边界
浏览器自动化可能接触账号、个人资料、业务表单和付款页面,因此每一步都应考虑是否需要用户确认。公开页面的信息整理通常风险较低;登录、修改个人数据、提交申请、发送消息或付款则可能产生实际后果。设计工作流时,可以把任务分为读取、草拟和提交三个阶段:读取阶段收集公开信息,草拟阶段准备内容,提交阶段由用户检查并明确确认。
远程调试也意味着外部工具可能获得较广的浏览器操作能力。试用时应使用独立浏览器配置或专用测试账号,避免把重要的登录会话暴露给不熟悉的工具;不需要时关闭远程调试,并检查日志和截图是否保存了敏感信息。对于自动填表,用户应先确认网站、字段和数据来源,避免让 Agent 根据不完整内容自行推断关键个人资料。
这些做法并不妨碍自动化提高效率,反而能让职责更加清楚:AI 负责整理和准备,人负责核对事实并批准重要动作。若某个步骤不能安全地自动化,可以让系统停下来提出问题,而不是为了“全自动”而隐藏不确定性。工具是否适用,应结合任务价值、错误后果、权限范围和可逆性一起判断。
版本变化与可复现记录
浏览器、模型服务、Agent 框架和 MCP 工具都在快速变化。文章发布日期是 2026 年 7 月,配置说明反映其发布时的产品接口和操作界面;之后版本可能改变安装方式、API 参数或权限提示。读者可以用文章理解组件关系,再核对各项目当前文档中的版本要求和安全设置。若要复现实验,记录模型名、工具版本、浏览器配置和任务输入,会更容易区分问题来自哪里。
对初学者来说,一个小而可验证的任务是良好的起点。先让工具读取公开网页并总结明确字段,再检查结果是否对应原文;之后再尝试生成表单草稿,但暂不自动提交。每增加一个工具或权限,都应验证它带来了什么能力以及可能暴露什么数据。这种逐步扩展的方法能帮助用户建立对 Agent 的实际认识,而不依赖宣传中的抽象承诺。
从个人博客的其他文章继续学习
Roy的个人站还收录 iOS 组件使用手册、URL Scheme、Anchor 应用、Docker 与 Swift 等主题。早期文章展示作者在客户端开发、软件配置和产品实践中的积累,近期 AI 自动化文章则延续了“从实际需求出发,尝试一个可运行方案”的写作方式。标签、分类和存档让不同年代的文章保持可检索,也便于读者看见同一作者的兴趣如何变化。
如果关注 AI 自动化,可以先阅读这篇入门文章,再分别查看模型服务、Agent 框架、Chrome 远程调试和 MCP 的官方资料;如果关注软件工程,则可以从 iOS 和 Docker 文章继续。Roy的个人站适合作为个人实践和技术思考的阅读入口。使用自动化工具时,把文章中的步骤视为特定日期的经验,结合当前版本文档、最小权限配置和人工确认流程,才能更稳妥地应用到自己的任务中。
本文依据 Roy的个人站首页和 2026 年浏览器自动化文章整理。模型服务、浏览器接口和 Agent 工具可能更新,文中的组件名称按原文记录,具体配置请以项目当前官方说明为准。