Ethan Blog:基础 RAG 如何连接文档检索与回答生成
从博客内容找到 RAG 入门主题
首页使用文章、周刊、分类、标签和关于等入口组织内容。文章列表里可以看到基础 RAG、语义分块 RAG 等连续主题,也包含 AI 编程工具相关记录。这样的排列为读者提供了一个由基础概念向细节主题延伸的阅读起点:先了解检索增强生成的基本链路,再继续观察不同文档切分方式会怎样影响检索。首页也展示其他个人记录,因此浏览时可以结合标题和栏目判断内容类型。
《RAG系列-基础RAG(Simple RAG)》围绕一个常见问题展开:语言模型如何利用模型参数之外的资料来回答问题。教程给出的思路是在生成回答之前先搜索文档,把检索出的相关内容作为上下文提供给模型。这样,系统的工作不只是直接向模型提问,而是增加了一个面向指定资料的查找步骤,再让生成环节依据找到的材料组织回应。
基础流程由文档准备开始
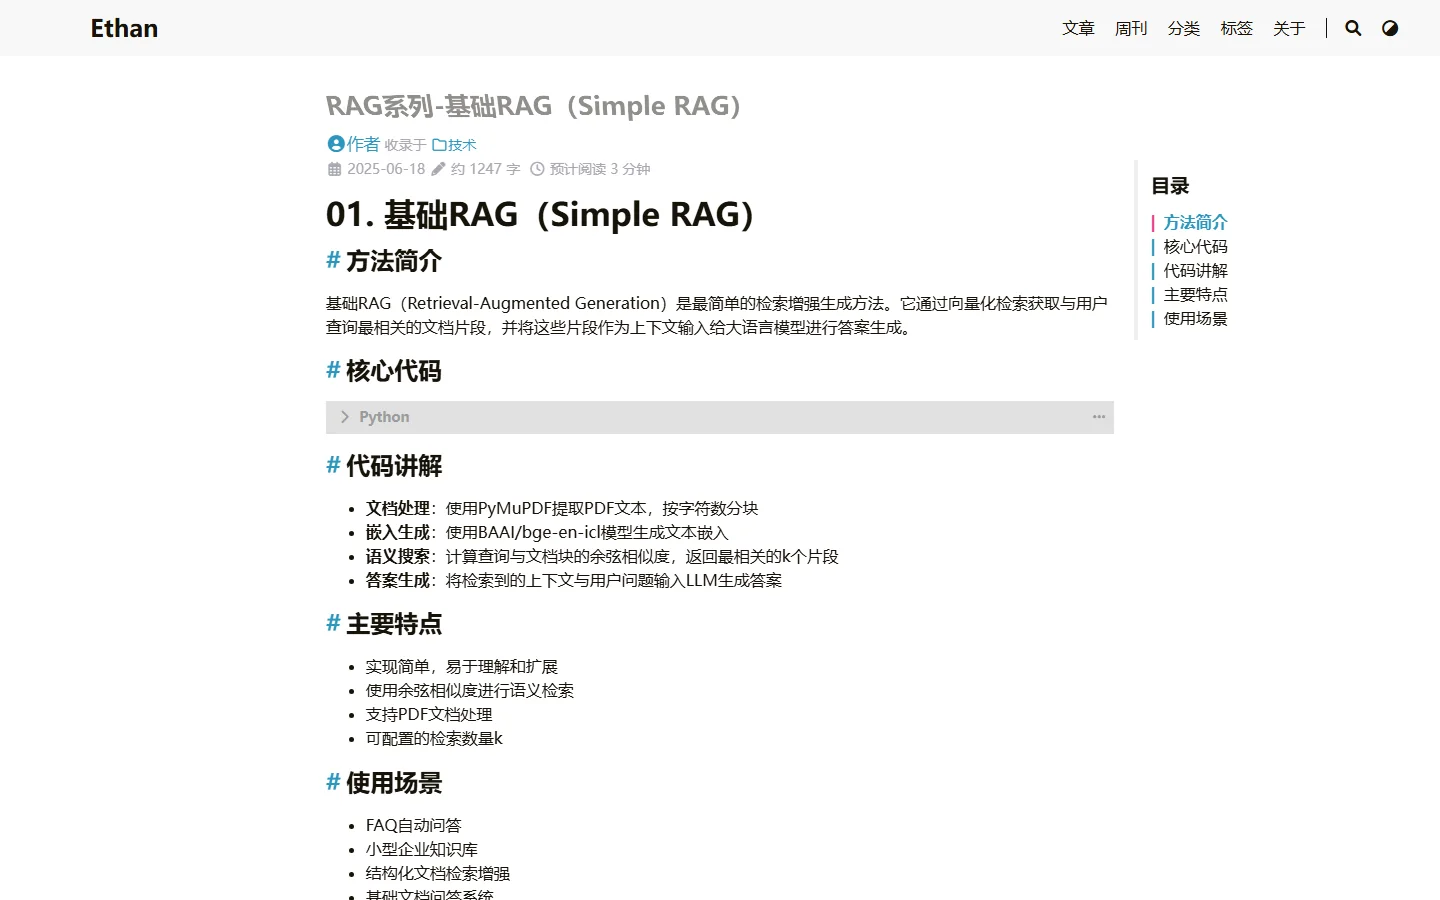
教程描述的流程首先要把可检索的资料整理成文本。资料可能来自 PDF 等文档,系统需要读取其中的文字,才能进一步处理。随后将较长内容分成多个片段。切分让检索可以在较小的文本范围内进行,也让被选中的内容更容易作为提示上下文交给模型。切分的大小和边界会影响片段表达是否完整;原教程将切分作为基础步骤介绍,并把语义分块列为系列中的后续主题,读者可以据此继续关注分段策略。
接下来,系统为文档片段生成嵌入向量。向量是文本在数值空间中的表示,后续可以据此比较查询和片段之间的语义接近程度。用户提出问题时,同样需要把查询转换成向量,再与已经准备好的片段表示进行比较。教程示例以余弦相似度衡量向量方向的接近程度,并从文档片段中找出较相关的内容。这个检索结果构成后续生成所需的材料,而不是把整个资料库原样塞进每一次请求。
检索结果如何成为回答上下文
检索完成后,系统把用户的问题和选中的资料片段组合成提示内容,再交由语言模型生成回答。可以把这一步理解为先找材料、再基于材料组织语言。检索负责从已有文档中挑出可能相关的部分,生成模型负责理解问题与上下文之间的关系,并形成可读的回应。两部分承担不同任务,所以检查系统时可以分别观察资料是否整理妥当、相似度比较是否找到合适片段,以及生成环节是否收到足够清晰的上下文。
教程的代码部分按 PDF 文本读取、切分、嵌入、相似度搜索和响应生成等环节展开。读者阅读示例时,可先追踪数据怎样从原始文件变成片段,再看查询如何与片段匹配,最后检查匹配结果在哪里被放进生成请求。沿着数据流理解代码,比单独记住函数名称更容易把握各步骤的连接关系。示例展示的是一个基础结构,具体项目仍需根据自己的资料格式和应用要求调整实现。
教程列出的应用方向
文章提到 FAQ 自动化、小型企业知识库和结构化文档检索等方向。FAQ 场景可以把已有问答或产品说明整理为可查找的内容;小型知识库可以让内部资料成为回答时的参考;结构化文档检索则强调从明确的资料集合中找到相关部分。它们共享的基本需求是拥有可供检索的材料,并能把问题与这些材料建立联系。应用是否合适,还取决于内容质量、更新方式、问题类型和回答核对机制,不能只凭流程名称判断效果。
对于刚接触 RAG 的读者,教程适合作为概念路线图:先准备文本,再分段并计算向量;收到问题后,检索相似片段;最后把片段连同问题送入生成环节。每一步都可以单独检查。例如,片段是否保留必要语境,查询是否能够找到对应段落,加入上下文后回答是否仍紧扣资料。按这些环节拆开观察,能够帮助读者定位问题来自资料准备、检索匹配还是回答生成,而不是把所有偏差都归结为模型本身。
从基础 RAG 继续阅读
首页还列出了语义分块 RAG,这为基础教程提供了后续阅读方向。基础方法先帮助读者认识检索加生成的整体结构;进一步阅读分块主题,则可以把注意力放在文档如何切分以及片段边界如何影响后续检索。两者属于同一系列中的不同层次,前者便于建立流程概念,后者提示读者继续考察资料组织的细节。网站同时收录编程工具等其他技术内容,读者可通过分类和标签寻找相近主题。
Ethan Blog 的这篇教程将基础 RAG 拆成可理解的步骤,适合需要建立知识库问答概念框架的开发者、学生和技术爱好者。阅读时可以把文档准备、语义匹配、上下文组织和回答生成分别记下来,再对照自己手头的资料判断哪些环节需要额外处理。若要把方法用于真实场景,还应结合具体数据检验检索片段是否相关、上下文是否完整,并核对生成内容是否忠实于所提供的资料。这样的分步理解,也方便继续阅读该博客列出的语义分块主题。