陈少文的网站:用 llms.txt 为 AI 提供网站导读
首页连接技术文章与专题趋势
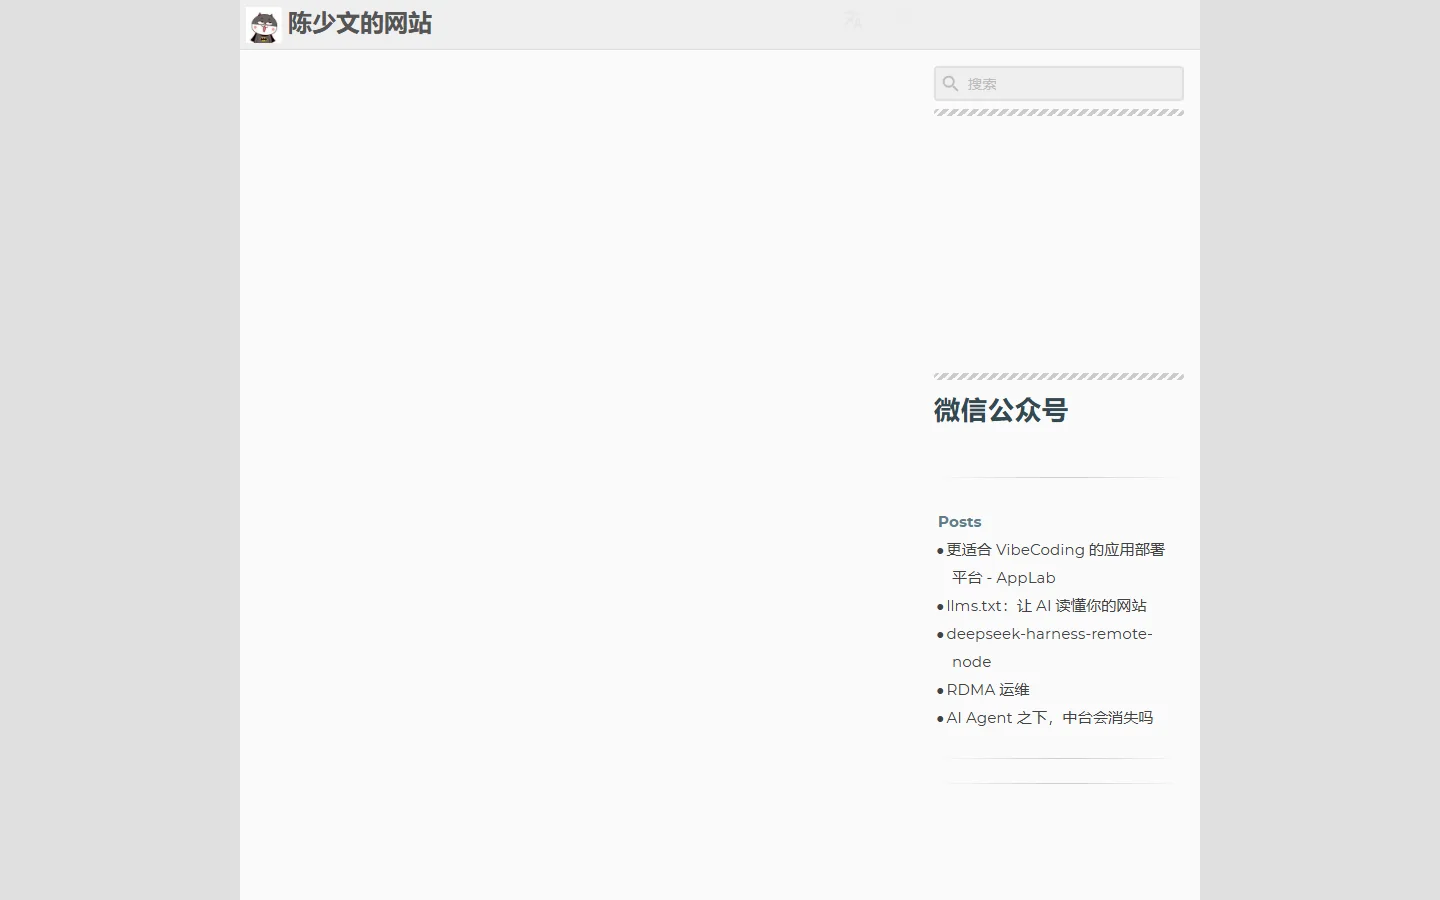
首页按时间列出近期文章,并标注发布时间、阅读时长和主题标签。内容涉及 AppLab 应用部署、llms.txt、DeepSeek Harness 远程节点、RDMA 运维和 AI Agent 对中台的影响,呈现出从基础设施工程到 AI 工作流的主题范围。网站提供趋势、标签、关于、隐私政策、订阅和中英文切换等入口,读者可以查看近期写作,也能转到单独的趋势大盘页面。
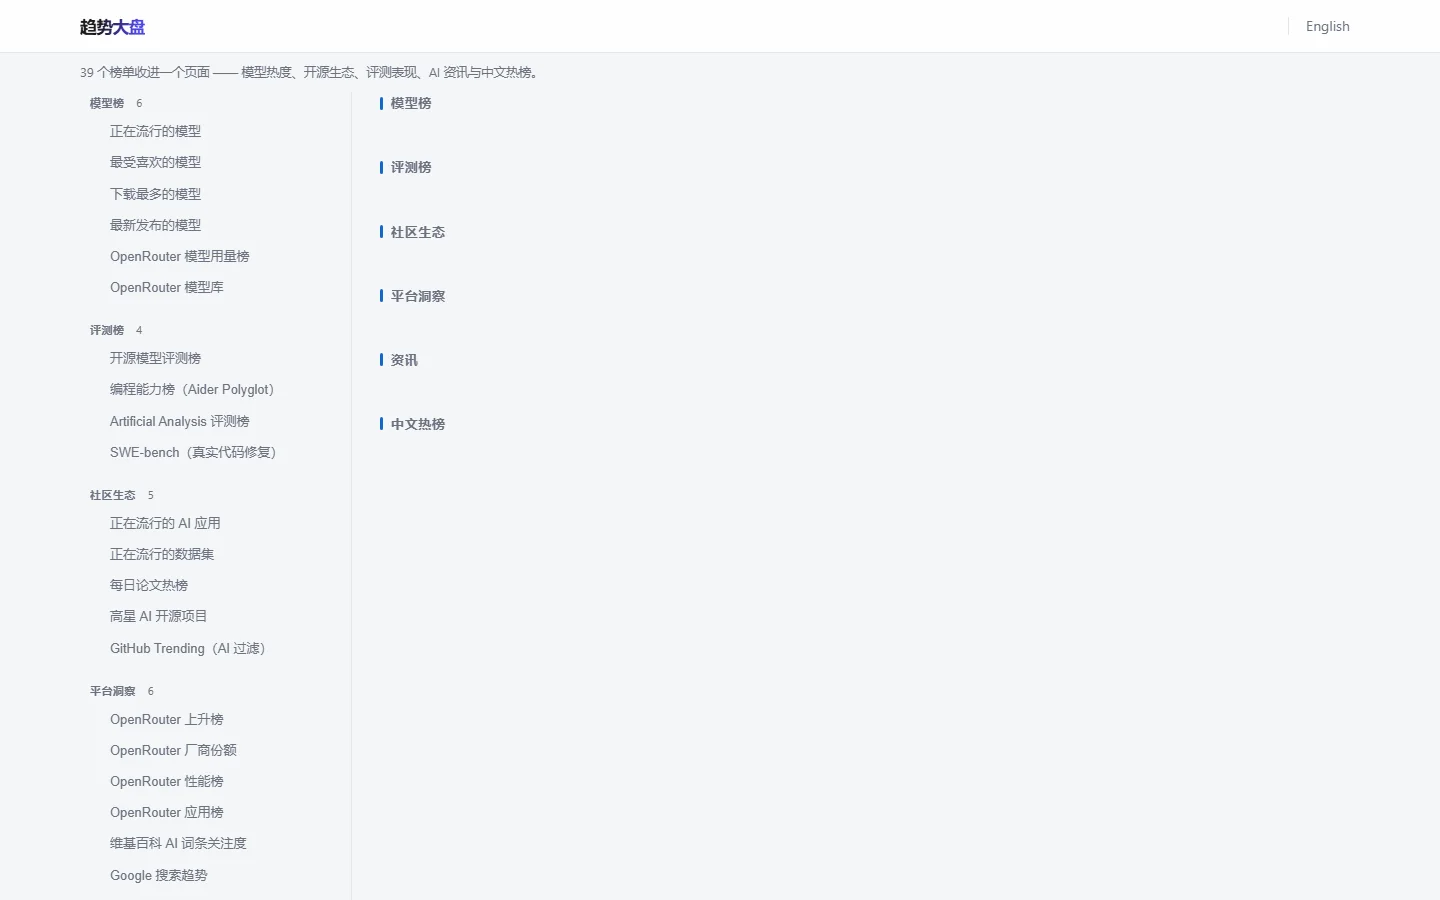
趋势大盘把不同榜单入口分成模型榜、评测榜、社区生态、平台洞察、资讯和中文热榜等类别,并在目录中列出模型热度、开源项目、论文、平台用量、AI 新闻及多个中文社区热榜。页面内容适合用来寻找不同类型的公开趋势来源。截图中能看到栏目目录和榜单名称,主要面板区域没有显示具体榜单数据,因此这里描述的是页面提供的导航结构,而不据此判断某一榜单的当前数值。
llms.txt 想解决的信息入口问题
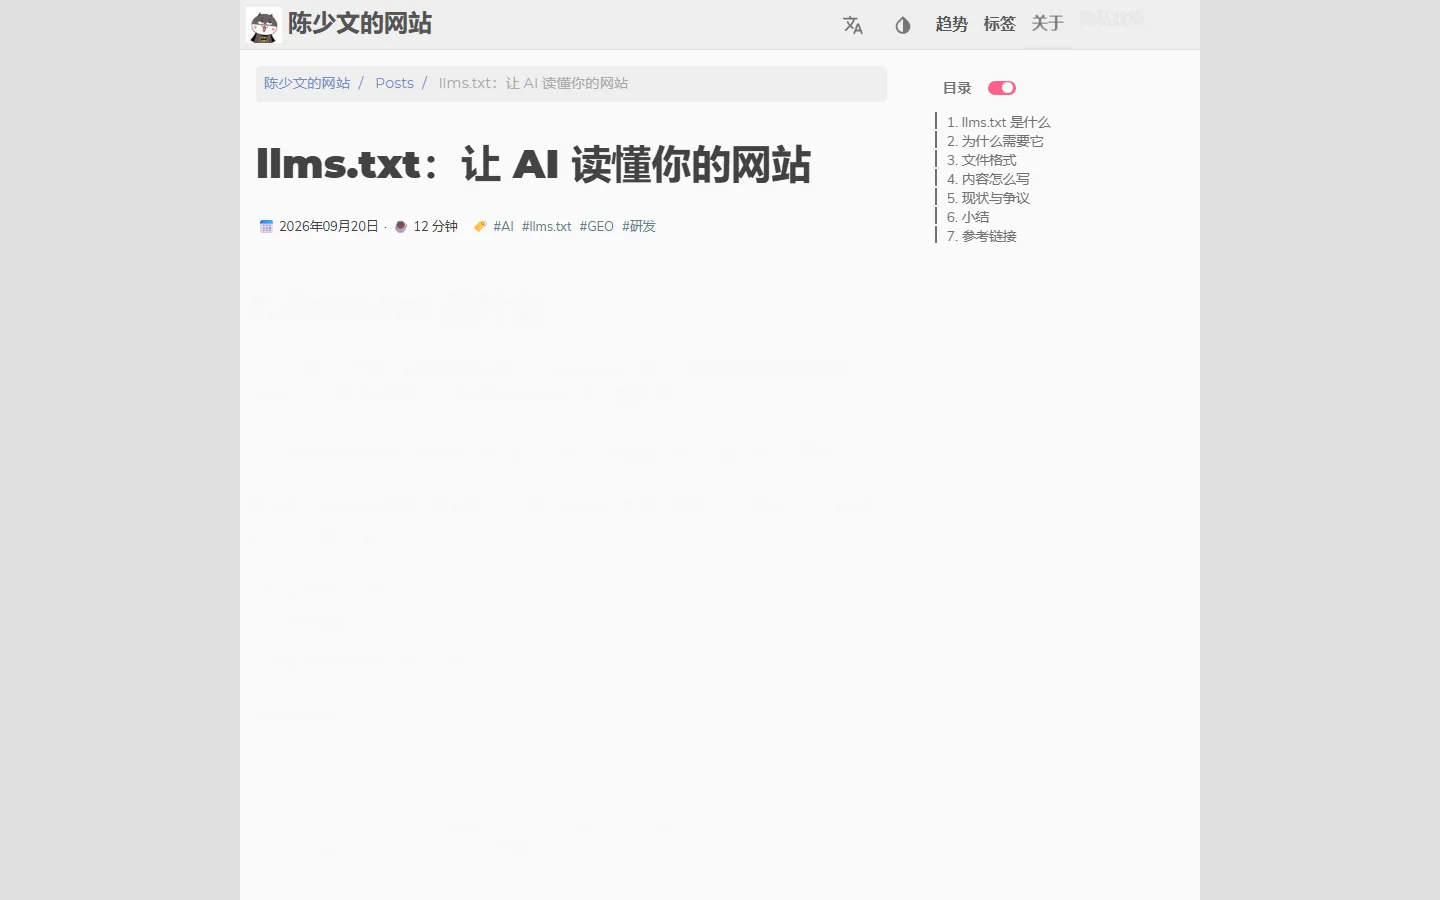
《llms.txt:让 AI 读懂你的网站》将 llms.txt 描述为放在网站根目录的 Markdown 文件,用自然语言说明网站是什么、哪些内容值得读,以及每篇文章大致讨论什么。文章提到这一提案由 Answer.AI 的 Jeremy Howard 于 2024 年 9 月提出,并把规范和参考实现列为进一步阅读入口。作者用一句话概括了它与 robots.txt 的区别:robots.txt 关注是否允许抓取,llms.txt 则试图为已抓取内容提供导读。
文章解释,直接将完整 HTML 页面交给模型时,正文之外往往还包含导航、侧边栏、广告位、Cookie 提示、脚本和样式等信息。模型需要先从这些内容中抽取正文,这会消耗上下文,也可能影响理解。对于拥有大量文章的网站,模型还需要找到适合当前问题的页面;如果站点缺少清晰的主题索引,内容虽然公开存在,却不容易被准确定位。
llms.txt 的思路是在入口处提供短小、可读、可链接的概览:先说明站点主题,再挑选重要内容并解释阅读价值。文中展示的示例包括站点介绍、核心内容类别和可选的辅助页面。读者能够看出它更像策展过的导航页,而不是复制整站内容的第二份数据库。文件保持普通 Markdown 形式,网站维护者可以直接检查和修改。
从“罗列链接”转向提供上下文
文章的目录将写作建议分为策展、说明每项内容能带来什么、摘要写清对象,以及 Optional 次要内容等部分。这些重点共同指向一个原则:条目不仅要列出 URL,也要告诉读者为何值得打开。若网站只堆积大量链接,读者仍需逐个访问才能辨别主题;若用简短描述解释页面覆盖的技术、对象和用途,模型和人就能更快判断相关性。
这一方式也要求维护者持续控制文件范围。重要页面应该优先出现,页面描述应具体而准确,次要入口可以放在可选部分。站点文章更新后,导读内容需要随之调整,删除已经过时或价值不高的条目。换言之,llms.txt 的效用取决于人工整理的质量,文件扩展名本身并不会自动替网站生成准确摘要,也不能保证模型一定读取或引用它。
文章进一步讨论 llms.txt 的现状与争议,并列出规范、参考项目和相关资料。将这一部分与写作建议一起阅读,有助于区分“可以尝试的发现与解释机制”和“已经被所有模型统一采用的技术标准”。网站作者提出的是一种公开约定和实践讨论,实际使用效果还与模型如何获取网站、抓取机制及文件内容质量有关。
网站自身如何示范导读内容
这篇文章本身介绍了一份指向陈少文网站的 llms.txt 示例,其中包括网站主题、中文内容方向和代表性文章类别。读者可以从中观察导读文件怎样把基础设施、云原生和 AI Agent 等内容压缩成几段概览,再链接到架构运维与 RDMA 主题。它为文章的解释提供了具体例子,也让访问者能从当前页面继续查看规范、示例仓库和站内专题。
对维护技术网站的人而言,可以先挑选少数核心页面试着写导读:主页介绍说明站点整体主题,核心栏目链接代表性内容,单条描述解释读者能获得什么。写完后再检查是否有重复介绍、是否覆盖过多次要页面,以及每一条能否准确反映目标页面。这样的编辑工作与常规网站导航互补:导航帮助访问者在页面间移动,导读则用文字说明页面之间的主题关系。
作为技术实践博客的其他内容
陈少文的网站还覆盖 AppLab、DeepSeek Harness 远程节点、RDMA 运维和 AI Agent 等文章。AppLab 条目讨论面向 VibeCoding 的应用部署平台;RDMA 文章聚焦运维配置;DeepSeek Harness 文章讨论 Agent 如何获取远程环境上下文。首页按近期发布时间呈现这些内容,标签和订阅入口补充了长期浏览与更新跟踪的方式。站内趋势大盘则将公开模型、评测和资讯榜单聚合为分类目录。
这些内容对开发者和基础设施从业者有不同用途:可以从单篇文章了解某项工具或工程问题,再由站内分类和外部链接继续寻找原始资料。技术环境会变化,特别是模型榜单、平台趋势和工具行为具有时间性;阅读时应核对文章日期,并对照项目文档或数据来源确认当前状态。网站提供的是实践记录和信息导航,不替代官方规范或实时数据源。
适合哪些读者
关心 AI 如何获取网站信息的读者,可以从 llms.txt 文章了解这一导读格式的目标、写作方式和争议;网站维护者可以借其示例思考如何为模型和访客整理站点入口。关注云原生、RDMA、Agent 工具与开发平台的人,可以通过首页的文章列表查找对应专题;想观察公开趋势入口的人,可以进入趋势大盘按模型、评测、社区和资讯分类浏览。
使用该网站时,适合把文章当作工程经验与观点入口,再依原文提供的规范、代码仓库和数据来源继续核实。llms.txt 是一种帮助整理站点内容的实践方向,不等于抓取许可控制,也不保证模型使用它;趋势页面的榜单目录能帮助发现数据源,但具体值仍需进入对应榜单确认。理解这些边界后,读者就能根据自己的任务在技术文章、趋势索引与站点订阅之间选择合适的阅读路径。