std::bodun::blog:机器学习系统与 TensorIR 学习笔记
归档围绕系统与机器学习展开
文章归档提供了比单篇首页摘要更清晰的主题线索。内容包括 TensorIR 编程与变换、机器学习系统、GPU 内存管理、分布式系统、深度学习框架以及论文阅读笔记。这样的组合面向希望理解模型训练或推理背后基础设施的读者:既能从一个算子实现进入,也能继续了解调度、资源使用和系统设计相关问题。博客以文章形式组织材料,不等同于完整课程或 API 文档。
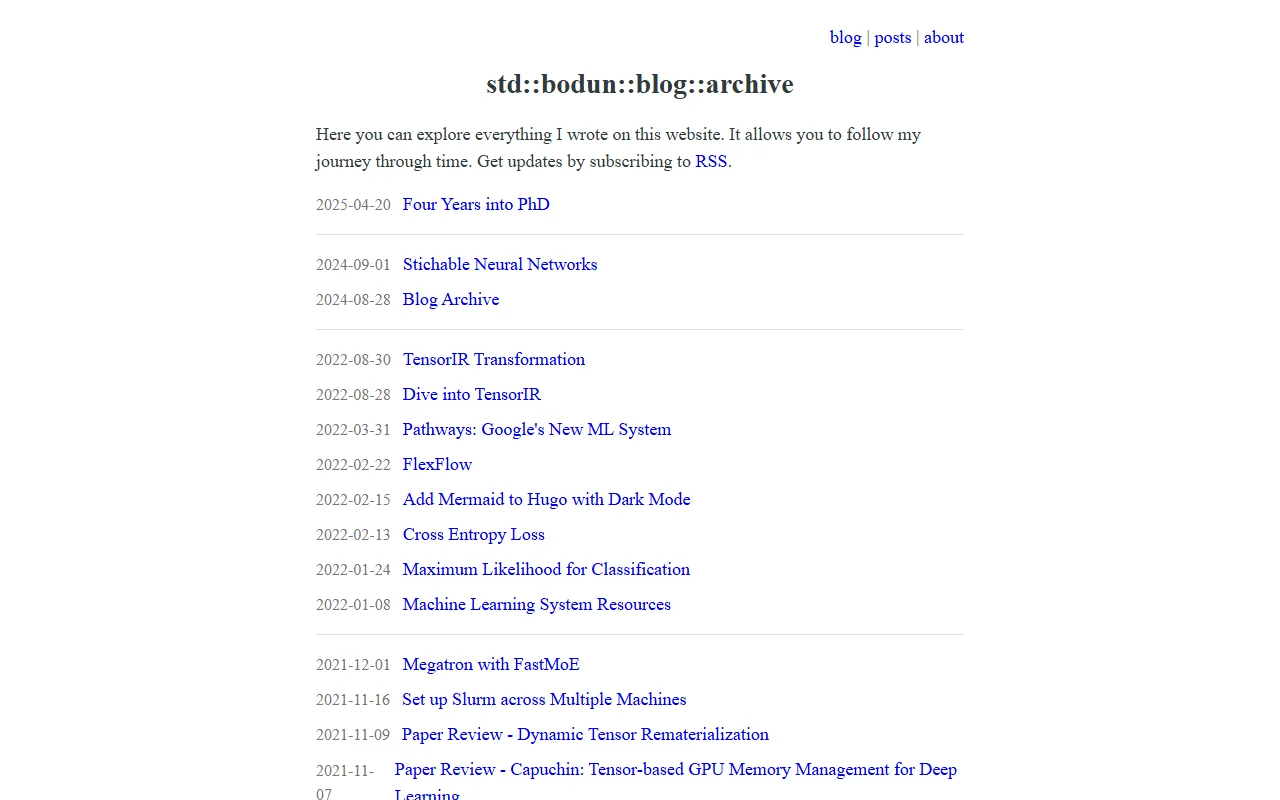
归档同时列出 Pathways、FlexFlow、Megatron 与 FastMoE 等系统主题,以及多机 Slurm 配置、分布式系统共识等基础设施文章。这些标题表明博客讨论范围从算子层实现扩展到多设备或多机器计算。读者可以先按标题判断目标,再进入相应文章;若正在查找框架当前用法,应同时查阅上游项目文档,避免把旧版本的代码样例当作当前接口。
TensorIR 文章从具体计算表达开始
《TensorIR Transformation》以批量矩阵乘法后接 ReLU 为例,先给出 NumPy 风格的循环计算,再把运算转为 TensorIR 的表达。文章示例使用固定形状的张量,通过循环遍历批次、行、列和归约维度计算矩阵乘法,随后将结果经过 ReLU 操作。这样的对照有助于读者看到高层数组代码与编译器中间表示之间的联系。
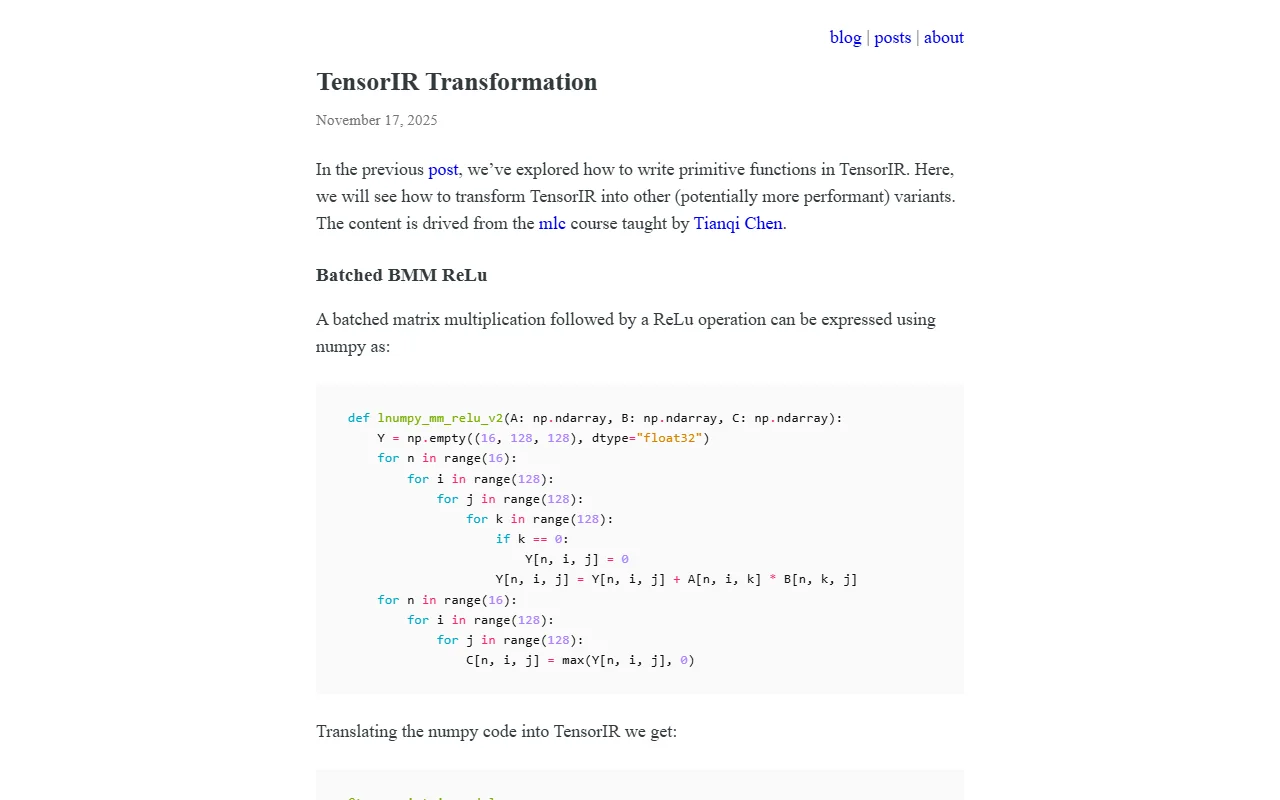
TensorIR 在这里不是简单的代码改写标签。文章将计算写成带有缓冲区、循环和计算块的结构,并进一步讨论如何变换成其他实现形式。读者可以从示例观察循环维度如何对应张量的批次与矩阵索引、归约维度如何表示累加过程,以及算子结果如何进入后续激活计算。理解这些映射之后,再阅读后续变换会更容易判断调度改变的是计算顺序、数据组织还是执行效率相关的结构。
这个案例也让性能讨论有了共同参照。若只看最终输出,多个实现都可能完成相同数学运算;对编译器而言,还需要表达程序结构,以便后续选择和调整执行方式。文章通过从 NumPy 到 TensorIR 的逐步展开,让读者先看到语义对应关系,再进入变换主题。它适合已经了解矩阵乘法和张量维度、希望理解机器学习编译器如何处理算子的读者。
从算子变换连接到执行效率
文章引言指出,TensorIR 可以被变换成其他、可能具有不同性能的形式。读者可以据此关注一个关键问题:保持计算结果定义的同时,如何改变程序表示,使其更适合目标硬件或执行安排。学习时,先确认输入输出形状与原始计算,再查看变换前后循环、计算块和数据访问方式的差异,比单独记忆某个 API 名称更容易形成理解。
性能结果通常依赖目标设备、编译器版本、输入规模和测量方法。博客文章的代码与解释可作为理解变换概念的学习材料,但不应直接推导出所有模型或硬件上的速度结论。读者若要复现实验,应先核对文章使用的 TVM/TensorIR 版本和教程环境,再按当前官方文档运行示例,并用一致的输入和测量流程比较实现。
其他系统文章提供相邻视角
TensorIR 主题之外,归档中的 GPU 内存管理与深度学习系统文章从资源约束角度补充了模型执行背景。多机 Slurm 配置和分布式系统共识则转向计算任务如何被调度、节点如何协作等问题。对于做模型推理或训练系统的读者,这些主题有助于建立从算子表达、设备资源到分布式执行的阅读路线;它们彼此相关,但每篇文章的范围仍需以正文为准。
博客也收录了机器学习系统相关资源和论文评述。读者可以把它们作为发现术语、系统名称和后续阅读方向的起点,再回到原论文、官方教程或代码仓库核实细节。研究系统更新很快,文章归档中的时间顺序适合了解作者曾经关注的问题,不意味着所有接口和结论仍与当前版本一致。
适合怎样的读者
如果你已掌握基本张量运算,正在学习机器学习编译、GPU 执行或分布式训练系统,std::bodun::blog 的文章归档提供了从具体算子到系统主题的多个入口。TensorIR 变换文章尤其适合先观察代码如何映射到中间表示,再追踪不同表示如何服务后续执行。对初学者来说,建议结合 TVM 和相关系统的当前文档补足背景;对有经验的读者,则可以把归档当作专题索引,按系统名称和问题方向继续查找。
总体来看,这个博客的特点是用具体代码和系统例子讨论机器学习软件栈中的实现问题。它不提供托管服务或在线计算工具,而是提供技术文章、学习笔记与专题线索。先从 TensorIR 的基础表达建立共同语境,再扩展到 GPU、分布式系统和框架主题,会更容易理解不同层次之间的关系,也能更有效地判断哪些内容与自己的研究或工程任务相关。