Shiroha白羽的博客:算法竞赛记录与块排序变换笔记
从分类和归档查找学习资料
博客的 ACM&算法分类收录了大量 Codeforces 赛事记录与解题笔记。按竞赛名称和日期排列的列表,方便读者在赛后回顾题目,也可以作为按时间持续练习的记录。其他分类还涵盖学习笔记和开发实现类内容,首页则汇集最新更新。标签可用于横向查找某种语言或技术,归档和 RSS 为长期阅读与订阅提供入口。
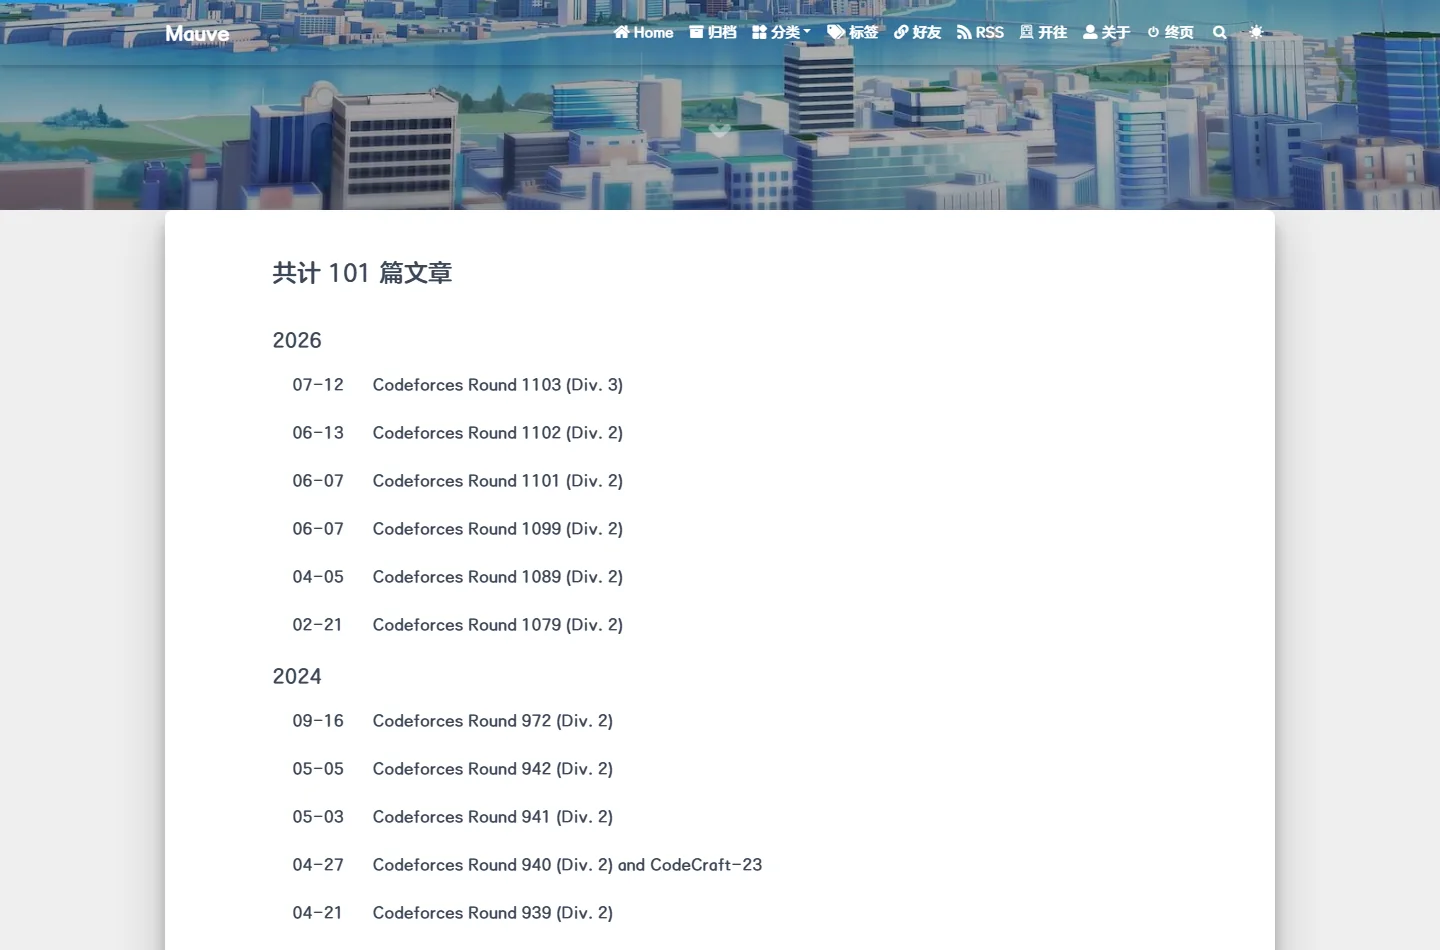
这类内容适合希望建立个人题解索引的学习者:可以先从比赛记录了解文章所处的上下文,再进入单题分析查看思路。对于更基础的主题,站内的算法笔记会解释概念和过程;对于编程实践,则可继续浏览不同语言与系统方向的文章。分类结构让竞赛练习和一般开发知识都能在同一站点中检索。
BWT 为什么先重排字符串
The Burrows-Wheeler Transform,常简称为 BWT,是压缩流程中常见的一种字符串变换。它本身并不直接减少输入长度;相反,加入结束标记后,数据通常会略微变长。它的作用是重新排列字符,使原文中相邻或相似的字符更集中。后续的游程编码、字典编码或熵编码等步骤,便可能更容易利用这种局部重复性。
文章用 banana 作为示例,并在末尾加入一个特殊结束符号。随后构造字符串的循环移位,将这些移位结果按字典序排列,再从排序后的矩阵中提取指定列,形成变换后的序列。这个过程把原串周围的字符关系重新组织起来;当重复模式存在时,结果往往会出现更长的相同字符段,为后续压缩算法提供更合适的输入。
排序视角解释算法结构
BWT 的关键观察在于排序后各行之间的字符关系。所有循环移位的长度相同,因此可以从末尾字符开始理解它们的顺序,再逐步纳入前面的字符。稳定排序让后一次排序在字符相同时保留之前的相对次序,最终形成与完整字符串排序相同的结果。文章借这个角度解释为何重复排序后能够回到原有的行排列逻辑。
变换过程之所以容易产生聚集效果,是因为相似前缀的循环移位会被排到相邻位置,而结果列记录这些行各自的前一字符。若原文在某些上下文里重复出现同一字符,排序后的相邻行就可能带来重复字符连续出现。读者可以通过小字符串手工构造循环移位矩阵,逐列观察排序如何改变字符排列,理解算法为何会产生可压缩的输出。
需要区分“变换”和“压缩”。BWT 负责改变表示方式,不保证输出比原文短;真正的压缩收益通常来自后续步骤,例如把连续重复字符编码成次数,或使用更短的码字表示高频符号。实际压缩系统会把变换与编码算法组合起来,整体大小还取决于输入内容、标记开销和编码策略。因此,不能仅凭 BWT 输出看起来重复更多,就断定任意数据都能压缩。
从变换结果恢复原文
BWT 需要可逆,解码端必须根据变换列和结束标记恢复原始字符串。排序后的第一列与最后一列之间保留着字符的对应关系;利用稳定排序建立的映射,可以逐步追踪字符在循环移位中的位置,并还原原文。直观理解时,可以把每行看成原字符串的一种循环偏移,并利用排序顺序恢复行与行之间的联系。
对学习者来说,先用短字符串验证每一步比直接记结论更有效:列出所有循环移位,排序,提取最后一列,再根据首尾列的稳定对应关系逆向重建。边界符号必须能与普通输入字符区分,否则循环移位无法唯一确定原文起点。不同实现对结束标记和索引的约定可能略有差异,编码与解码两端需要保持一致。
适合算法学习者的阅读方式
这篇文章从变换目的开始,再展示操作步骤,最后解释排序原理,适合作为字符串算法的入门笔记。读者可以先跟随 banana 示例完成矩阵,再自己选一个带重复字符的短词测试输出,比较重排前后的连续重复情况。之后再阅读实际压缩程序如何把 BWT 与其他编码步骤结合,便能区分各个阶段分别解决的问题。
博客的 Codeforces 分类提供持续的竞赛题解记录,BWT 笔记则面向独立算法概念,两类文章共同构成编程学习资料。初学者可以用分类和归档寻找连续内容,已有经验的读者则可以通过标签快速定位特定语言或主题。站点同时提供 RSS,适合希望跟踪新文章的人订阅。
总体而言,Shiroha白羽的博客适合算法竞赛参与者、计算机专业学生和希望持续积累编程笔记的开发者。BWT 专题强调重排的直觉与排序关系,帮助读者理解为什么一种不直接缩短数据的变换会对后续压缩有帮助。阅读时应把它放回完整压缩流程中理解,并通过具体字符串验证正向变换和逆向恢复。