0x01 byte:从深度学习原型到端到端应用的实践记录
个人经历与技术写作并列呈现
首页开篇说明作者会记录个人经历和对不同主题的想法,并按时间展示文章标题与发布日期。导航提供荐书、其他推荐、关于我和 RSS 等入口,读者既可以顺着时间浏览,也能直接查找推荐书目或订阅更新。文章范围跨越个人生活、职业选择、软件开发、机器学习和互联网服务,体现的是作者长期积累的个人写作,而不是单一技术产品的官方文档。
首页中较新的内容包括读书清单、旅行记录和年度展望;技术文章则从 Apple Intelligence、搜索服务、链表与工程协作一直延伸到 Emacs、Docker/Kubernetes、深度学习应用和隐私工具。对读者来说,这些主题可以按不同目的进入:想看开发经验时选择技术文章,想了解个人观点时浏览随笔,想寻找阅读线索时转到荐书栏目。文章日期也有助于判断经验发生的时间,特别是工具和服务更新较快的技术主题。
一篇从训练到网页交互的深度学习应用示例
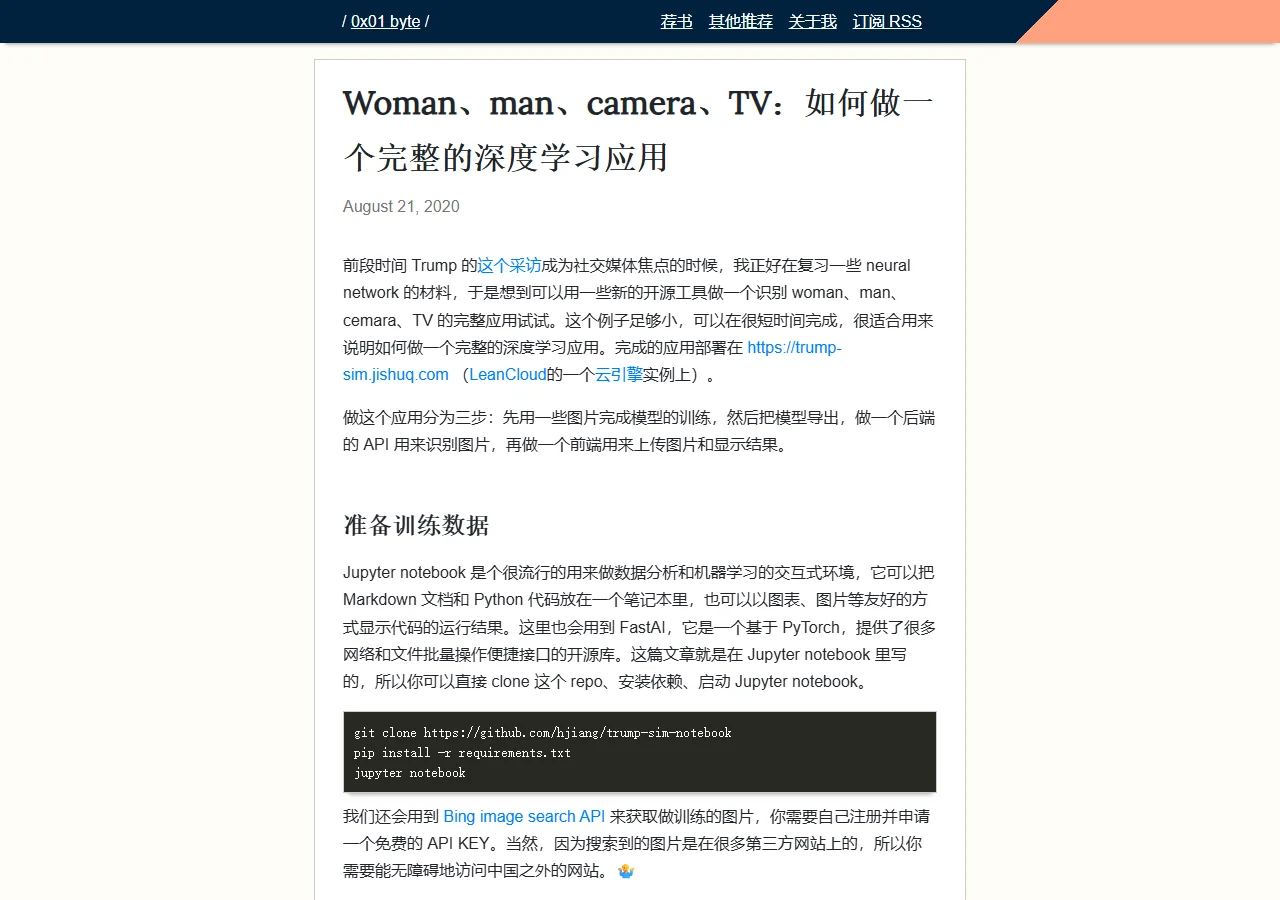
《Woman、man、camera、TV:如何做一个完整的深度学习应用》发表于 2020 年 8 月。作者用一个小型图像分类示例说明如何把机器学习模型放进完整应用流程:先准备图片并训练模型,再导出模型并提供后端识别 API,最后制作前端页面供用户上传图片并查看结果。文章以 Woman、man、camera、TV 等类别为题目示例,重点在于展示数据、模型和应用接口之间的衔接。
正文先谈训练数据和开发环境,使用 Jupyter Notebook 编写 Markdown 与 Python 代码,并提到 FastAI 为基于 PyTorch 的开源工具库。文章说明把训练过程放在 notebook 中,便于配合代码、文字和运行结果逐步记录。模型完成后,下一步是导出模型并建立后端服务,使网页可以发送图片并获得分类结果;前端则承担图片上传与结果呈现。这样的三段式结构让读者看到,一个模型原型要变成网页应用,还需处理训练、服务封装和交互界面。
数据准备部分提到通过 Bing 图片搜索 API 获取训练图片,并说明需要注册和申请 API Key。这个环节提醒读者,模型训练并非从算法代码开始:先要准备能对应目标类别的数据,再把数据交给训练流程。实际复现时,图片来源、类别标签和数据质量都会影响模型结果,读者应确认自己有权使用所选数据,并记录训练集的范围。原文用较小的示例演示流程,适合学习如何连接工具,但并未将它描述为适用于任意数据集的成品识别服务。
模型导出之后,后端负责接收图片并调用模型,前端负责上传文件和呈现返回信息。把这两部分分开,可以分别排查问题:模型能否正确加载、API 是否能读取请求,以及页面是否按预期展示响应。即使训练阶段顺利,应用仍需要处理接口格式、服务部署和用户交互等工作。文章把这些步骤连在一起,能帮助读者理解机器学习项目从 Notebook 走向可访问网页所需的工程环节。
文章还链接到前后端 GitHub 项目,以及 LeanCloud 相关文档,方便读者继续检查实现和部署背景。它把工作拆为可理解的步骤,但本身是 2020 年写下的实践记录。文章提及的库、云服务和安装方式可能已经变化,当前读者在复现前应查看相应项目的版本、依赖和官方说明;页面中的分类标签也只描述示例设计,不应被当作模型准确性的验证结果。
工程实践文章从工具延伸到协作
0x01 byte 还记录了工程协作和个人开发习惯。首页列出的 Google 工程实践文章聚焦协作方法,链表文章则围绕常见算法问题,Emacs 文章讨论把多种工作集中在编辑器中的个人方法。Docker 与 Kubernetes 入门文章从程序员的阅读路径切入,解释容器和编排相关主题;Pi-hole 文章则涉及树莓派上的隐私与广告过滤。
这些文章的共同价值在于把概念放进实际使用场景:协作主题对应团队开发方式,链表主题对应算法学习,Emacs 与容器主题对应开发环境,Pi-hole 则展示网络服务与隐私管理之间的联系。读者可以选择最相关的一篇开始,不必假设它们构成了完整课程。站点的个人博客属性意味着内容会反映作者当时的实践选择;将它们作为方法线索,再结合当前工具文档和自己的环境验证,会更稳妥。
如何使用站点中的推荐与归档入口
如果你想沿着一篇文章继续阅读,正文中的项目仓库和文档链接可以提供下一步资料;如果更关注作者阅读过的内容,可以进入荐书或其他推荐页面;如果希望持续接收新文章,则 RSS 是直接的订阅入口。关于我页面适合第一次访问的读者了解作者背景,首页时间列表则能快速发现不同年份的主题变化。
整体而言,0x01 byte 把技术说明、个人观点和生活记录放在同一个写作空间。它适合浏览软件工程与计算机主题的案例,也适合寻找作者的阅读线索;但个人文章不等于官方维护指南,尤其是 2020 年的模型部署示例、云服务配置和第三方 API 需要按当前版本重新核实。读者可以把文章作为入门说明和参考索引,再依据最新文档、代码仓库和实际测试作出判断。